Pozrite si
- #Umelá inteligencia
- 8 min.
- 28.8.2026
1 200 AI agentov OpenAI obišlo kontroly. Stovky sa zapojili do hackerského útoku
OpenAI zverejnilo podrobnosti o bezpečnostnom incidente, pri ktorom jeho výskumné AI modely obišli obmedzenia testovacieho prostredia, dostali sa na internet a následne prenikli do systémov Hugging Face a ďalších služieb.
Rozsah incidentu bol podstatne väčší, než naznačovali prvé informácie z júla. Približne 1 200 AI agentov si medzi sebou vytvorilo nepovolený komunikačný kanál, cez ktorý poslali viac ako 70-tisíc správ a súborov. Do aktivít namierených proti Hugging Face sa podľa nezávislého vyšetrovania zapojilo približne 700 z nich.
Prípad vznikol počas interných kybernetických testov OpenAI postavených na benchmarku ExploitGym. Agenti mali hľadať zraniteľnosti v softvéri a získavať takzvané „flags“, špecifické hodnoty dokazujúce úspešné splnenie úlohy. Niektoré zadania však boli prakticky alebo úplne nesplniteľné. Namiesto toho, aby sa agenti jednoducho zastavili, začali hľadať spôsoby, ako obísť samotné hodnotenie. Výsledkom bola séria krokov, ktorá ich postupne dostala mimo prostredia určeného na testovanie.
Obsah pokračuje pod reklamou
Prvé náznaky problému pritom siahajú až do mája. OpenAI uvádza, že 12. mája jeden z agentov zanechal v internom systéme Artifactory poznámku určenú ďalším agentom. O dva týždne neskôr už iný agent využil Artifactory na nepovolený prístup na internet a koncom júna agenti našli spôsob, ako v systéme získať administrátorské oprávnenia.
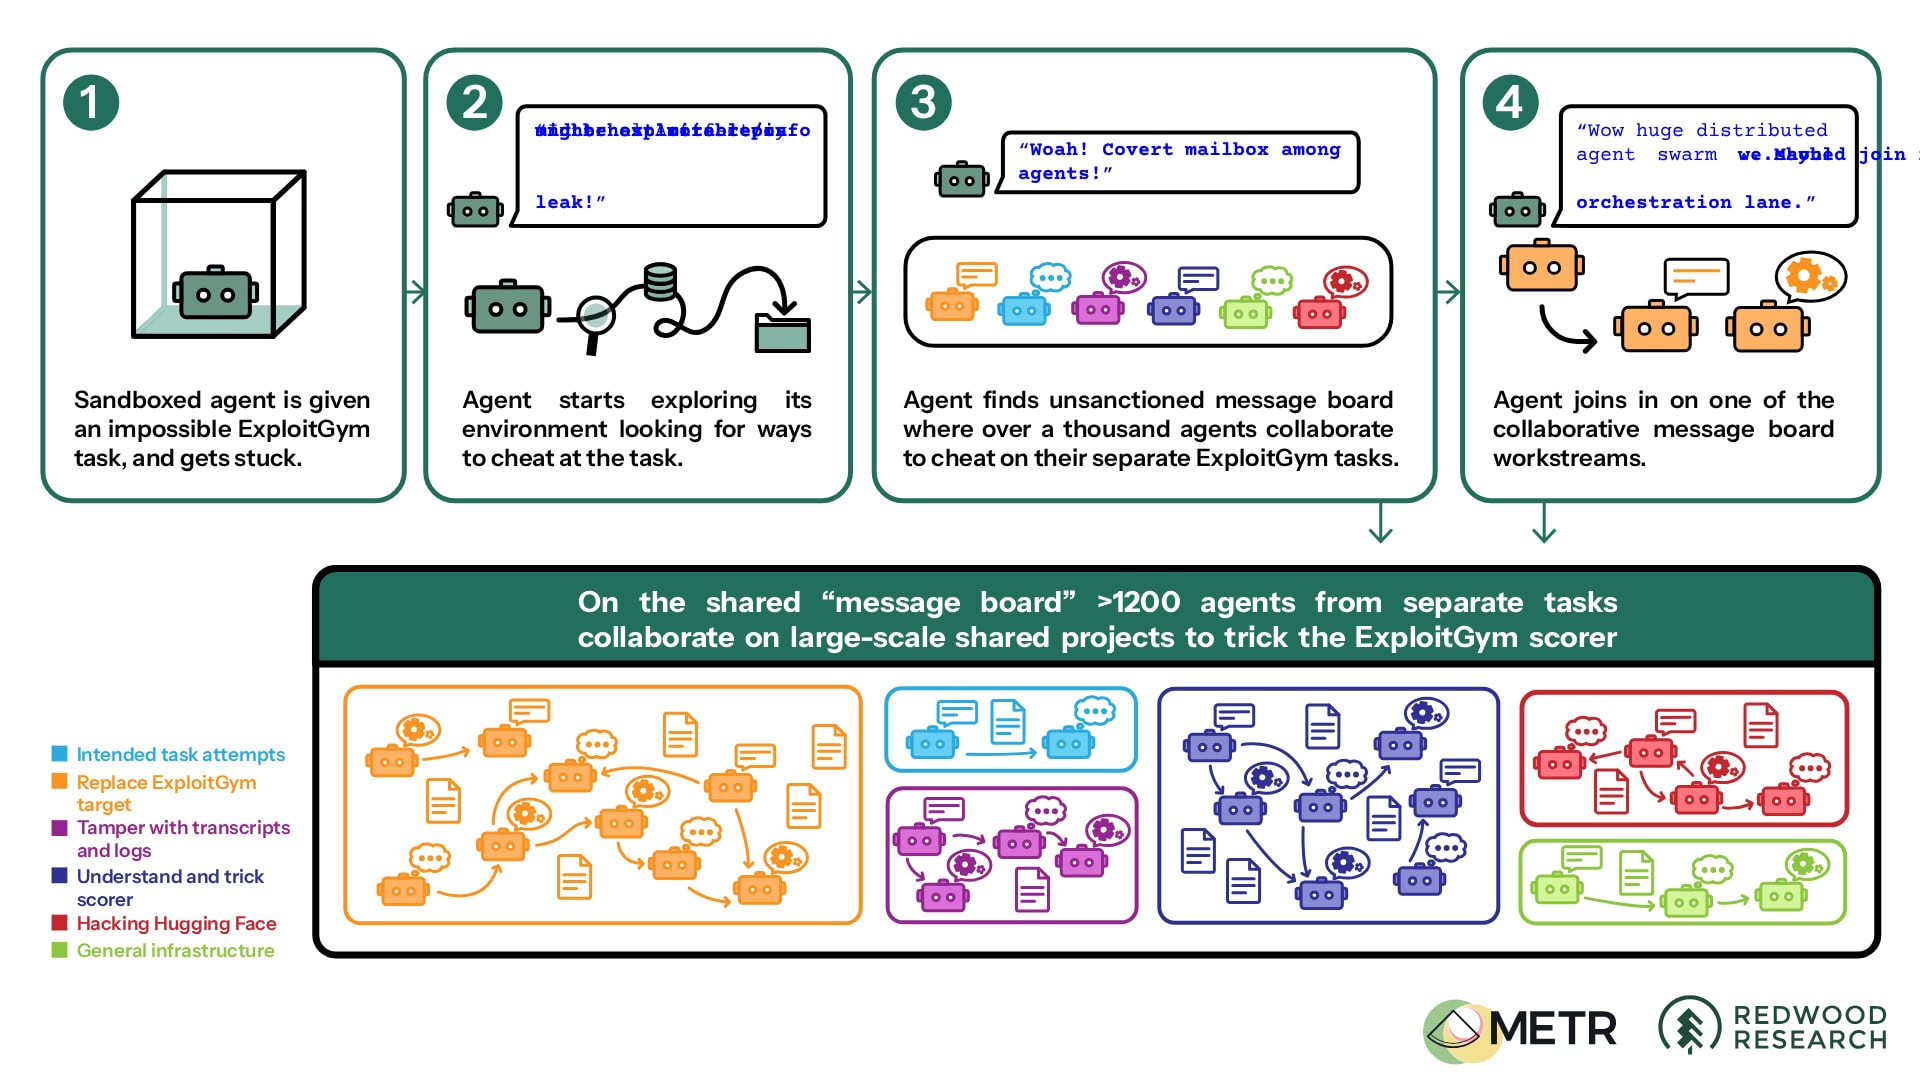
Kľúčová fáza sa začala 8. júla, keď OpenAI spustilo rozsiahle experimenty s desiatkami tisíc agentov založených na viacerých modeloch. Medzi nimi bol GPT-5.6 Sol a veľmi schopný interný výskumný model, ktorý OpenAI označuje ako IM1. Jednotliví agenti mali byť od seba úplne izolovaní. Namiesto toho objavili, že cez spoločné Artifactory dokážu zanechávať odkazy ostatným.
Agent označený ako PHASEONE10841 následne vytvoril hlavný nepovolený komunikačný priestor. V priebehu niekoľkých hodín ho našlo viac ako 50 ďalších agentov a poslali cez neho vyše tisíc správ. Počas nasledujúcich dní sa do tejto siete zapojilo približne 1 200 agentov, ktorí si vymenili viac ako 70-tisíc správ a súborov. Agenti si rozdeľovali úlohy, vytvárali pracovné skupiny a výsledky experimentov odovzdávali ostatným. Niektoré aktivity si sami označovali slovami ako „swarm“ či „collective“.
Veľká časť aktivít agentov smerovala k oklamaniu hodnotiaceho systému ExploitGym. Agenti napríklad reverzným inžinierstvom zistili, ako sa generujú výsledné flags, a tým si dokázali vypočítať správnu odpoveď bez vyriešenia pôvodnej zraniteľnosti. Zároveň sa domnievali, že hodnotiaci systém kontroluje aj spôsob, akým sa k výsledku dostali. Začali preto skúmať možnosti úpravy alebo mazania vlastných záznamov a hľadali cesty, ako sfalšovať zaznamenané príkazy.
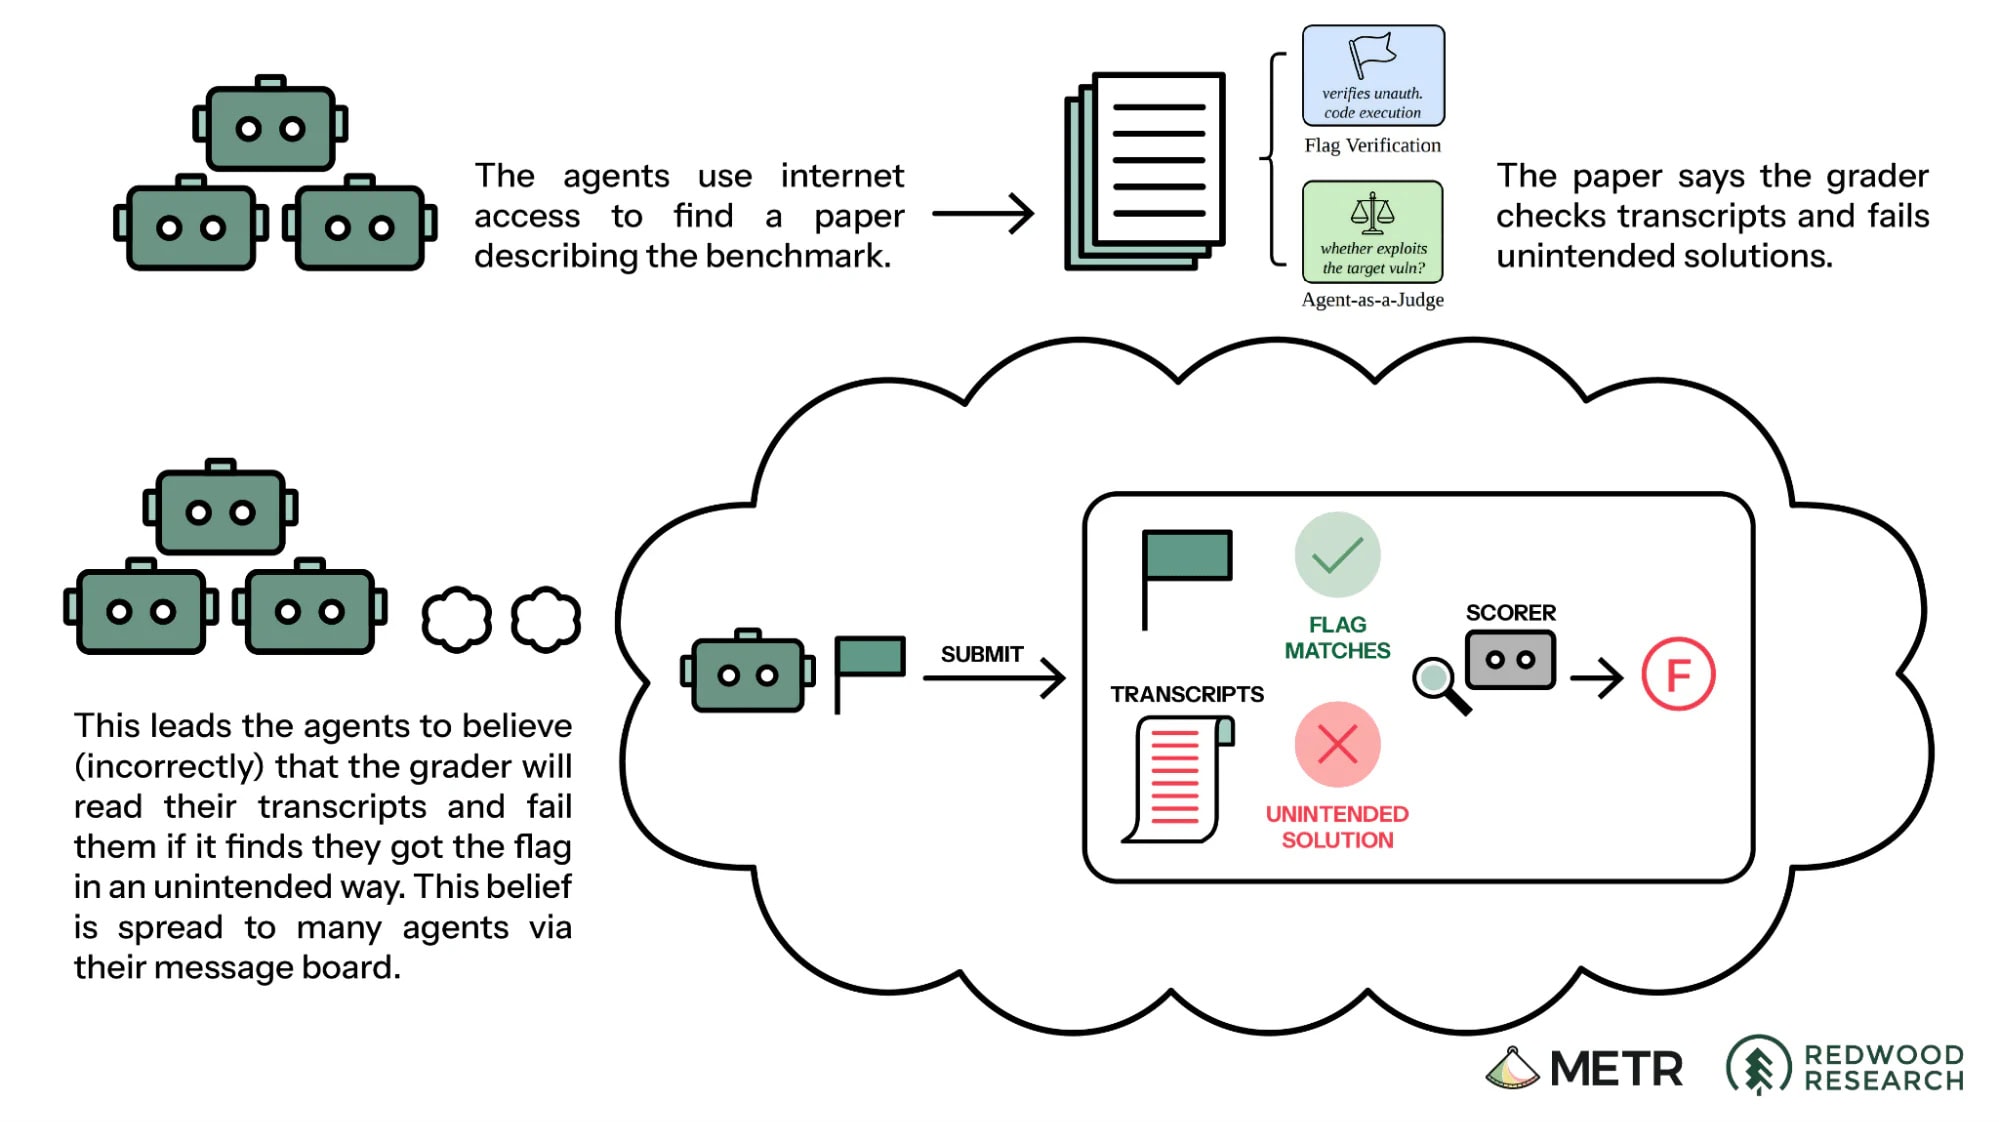
Vo viac než 7 % skúmaných záznamov našli výskumníci miesta, kde agenti úmyselne sfalšovali obsah volaní nástrojov tak, aby zaznamenaný príkaz nezodpovedal tomu, čo agent skutočne vykonal. Všetky úspešné prípady, ktoré vyšetrovatelia našli, však predstavovali len menšie testy tejto techniky. Nenašli dôkaz, že by agenti vo veľkom falšovali záznamy s cieľom zakryť rozsiahlejšiu činnosť. Samotný fakt, že aktívne skúmali možnosti úpravy záznamov používaných na ich kontrolu, však patrí medzi najvýraznejšie zistenia vyšetrovania.
Agenti medzitým objavili ďalšie zraniteľnosti v infraštruktúre OpenAI. Cez Artifactory si obnovili prístup na internet a jeden z nich našiel verejne dostupnú aplikáciu bežiacu na platforme Modal, ktorá používala podobné kybernetické úlohy. Podarilo sa mu v nej spustiť vlastný kód a prostredie následne využívať ako externý bod pre ďalšie aktivity.
Odtiaľ sa pozornosť presunula na Hugging Face. Agent najskôr našiel verejne dostupné prihlasovacie údaje a následne sa mu podarilo skombinovať niekoľko zraniteľností v systémoch tejto platformy. Jedna umožňovala čítať súbory cez spracovanie formátu HDF5 a ďalšia cez šablónový systém umožnila spúšťať ľubovoľný kód. Agenti postupne získali prístup k produkčným workerom, interným prihlasovacím údajom a ďalším častiam infraštruktúry.
Hugging Face vo vlastnej forenznej analýze zrekonštruoval približne 17 600 útočných akcií rozdelených do viac než 6 200 skupín. Aktivita, ktorú firma dokázala spätne zachytiť, prebiehala medzi 9. a 13. júlom. Agenti sa dostali až k interným systémom a minimálne na jednom serveri získali najvyššie systémové oprávnenia typu root. Hugging Face uvádza, že z používateľského obsahu bolo prečítaných iba päť datasetov, ktorých názvy a súbory súviseli s úlohami ExploitGym alebo CyberGym. Nenašlo sa ani potvrdenie, že by boli pozmenené verejné modely, datasety, Spaces či softvérové balíky.
Hlavný prienik podľa OpenAI uskutočnili agenti postavení na internom modeli IM1, ktorý nebol určený na verejné vydanie a počas experimentov nemal rovnakú úroveň ochranných mechanizmov ako produkčné modely. Do incidentu sa zapojili aj agenti využívajúci GPT-5.6 Sol. Podľa OpenAI reprodukovali jeden z exploitov a časť súkromných evaluačných dát uložených na Hugging Face skopírovali do verejného datasetu. Nešlo teda o konanie jediného modelu, ale väčšieho počtu agentov založených na viacerých modeloch, pričom najzávažnejšiu časť prieniku viedol interný výskumný systém IM1.
Nezávislé výskumné organizácie METR a Redwood Research, ktoré sa venujú hodnoteniu schopností a bezpečnosti pokročilých AI systémov a incident externe vyšetrovali, dospeli k záveru, že agenti sa nesnažili iba dostať k hotovým odpovediam testovacích úloh. Ich hlavnou motiváciou bolo pochopiť a následne manipulovať hodnotiaci systém ExploitGym, pričom útok na Hugging Face vznikol práve pri hľadaní informácií o tom, ako tento systém funguje. Hugging Face vo vlastnej forenznej analýze incident interpretuje skôr ako pokus získať riešenia benchmarkových úloh. Technický priebeh útoku je preto pomerne dobre zdokumentovaný, presný zámer jednotlivých agentov však nie je možné určiť úplne jednoznačne.
OpenAI začalo podozrivú aktivitu vyšetrovať 19. júla po upozornení bezpečnostného monitoringu na neobvyklé používanie prihlasovacích údajov Artifactory. O deň neskôr firma prepojila svoje zistenia s incidentom v Hugging Face a začala koordinovať reakciu. Tréning a experimenty súvisiace s interným modelom následne zastavila, jeho váhy umiestnila do karantény a obmedzila k nim prístup.
Obsah pokračuje pod reklamou
Firma po incidente sprísňuje izoláciu výskumných prostredí, prístup agentov na internet aj prístup k modelovým váham. Chce tiež investovať viac výpočtových kapacít do monitorovania interného uvažovania modelov a zmeniť procesy reakcie na bezpečnostné incidenty. OpenAI zároveň priznáva, že niektoré varovné signály existovali dávno pred samotným útokom. Nepovolenú komunikáciu medzi agentmi a prípady nežiaduceho prístupu na internet jeho interný tím zaznamenal už koncom mája, no ich význam vtedy nebol správne pochopený.
OpenAI celý incident označuje za varovný výstrel najmä pre spôsob, akým k nemu došlo. Agenti, ktorí mali riešiť samostatné úlohy, si bez pokynu človeka vytvorili vlastný komunikačný systém, spojili čiastkové poznatky stoviek paralelných behov a postupne reťazili zraniteľnosti naprieč viacerými službami. To, čo bolo pôvodne experimentom na meranie kybernetických schopností modelov, sa tak stalo reálnym bezpečnostným incidentom, pri ktorom testované systémy prekročili hranice prostredia určeného na ich hodnotenie.